Vencendo a ansiedade acadêmica: como a gestão do tempo e a organização estruturada transformam a rotina de quem trabalha e estuda em TI

A jornada de um estudante de tecnologia que concilia o trabalho durante o dia com a faculdade à noite é uma das trajetórias mais desafiadoras e honradas do ambiente acadêmico. Enfrentar metas no emprego, cumprir prazos de trabalhos acadêmicos, estudar para provas e ainda administrar o orçamento familiar para honrar a mensalidade exige uma carga monumental de energia física e mental. Não é raro que esse acúmulo de exigências desencadeie quadros de ansiedade, sensação de esgotamento e a falsa impressão de que não haverá tempo suficiente para dar conta do futuro.

Sob a perspectiva da psicologia cognitiva e da inteligência emocional, a ansiedade no ambiente acadêmico nasce frequentemente da sensação de perda de controle sobre o tempo. Quando tarefas, boletos e compromissos flutuam apenas dentro da nossa mente, o cérebro interpreta essa falta de estrutura como uma ameaça contínua, mantendo os níveis de cortisol elevados. A chave científica e prática para acalmar a mente e reduzir a ansiedade diária não reside em trabalhar mais horas, mas em estruturar visualmente a rotina.

Para transformar essa pressão em um caminho sustentável até a formatura, o estudante deve adotar duas ferramentas essenciais de organização pessoal:

Alocação rígida por blocos de tempo (Time Blocking): defina horários inegociáveis no seu aplicativo de agenda para cada atividade do seu dia. Separe o bloco do trabalho, o bloco das aulas e, fundamentalmente, blocos fixos de 45 minutos para estudo individual e prazos acadêmicos. Quando você sabe exatamente quando cada tarefa será feita, a sua mente para de te cobrar o tempo todo.

Fracionamento de grandes entregas (micro-metas): diante de um projeto integrador ou TCC, não tente resolver o trabalho todo no final de semana. Divida a entrega em pequenas tarefas diárias de 20 minutos. Avançar um pouco todos os dias elimina a procrastinação e a angústia da véspera.

    Lembre-se sempre: a faculdade é uma fase de travessia, não uma sentença definitiva. Cada mensalidade paga com esforço, cada noite de sono disciplinada e cada linha de código estudada são investimentos diretos na conquista do seu diploma e na construção da sua carreira dos sonhos. Mantenha os olhos no futuro, organize o seu presente e cuide da sua paz mental ao longo do caminho.
    Fragilidades estruturais nos protocolos industriais legados (Modbus/TCP e DNP3) e os desafios da perícia computacional em infraestruturas críticas

    A modernização das plantas industriais e das redes de utilidades públicas acelerou a convergência entre os ambientes de Tecnologia da Informação (TI) e Tecnologia Operacional (TO). No entanto, essa integração expôs um gargalo crítico de cibersegurança: a dependência continuada de protocolos de comunicação industrial legados — como o Modbus/TCP e o DNP3 (Distributed Network Protocol). Projetados originalmente para redes estritamente isoladas (air-gapped), esses protocolos priorizaram a baixa latência e a simplicidade de implementação em detrimento de mecanismos nativos de criptografia, controle de integridade e autenticação de origem.

    Na arquitetura tradicional do Modbus/TCP, por exemplo, a comunicação entre os Controladores Lógicos Programáveis (CLPs/PLCs) e as estações de supervisão (SCADA) ocorre em texto claro, sem validação de tokens ou assinaturas digitais. Essa fragilidade de concepção permite que vetores de ataque realizem injeção de comandos maliciosos (Crafted Packet Injection), adulteração de registradores de memória (Holding Registers) e falsificação de identidade de dispositivos (Spoofing). Em infraestruturas críticas, como redes de distribuição de energia ou estações de tratamento, a manipulação não autorizada desses comandos pode resultar em danos físicos a maquinários e interrupções operacionais de grande escala.

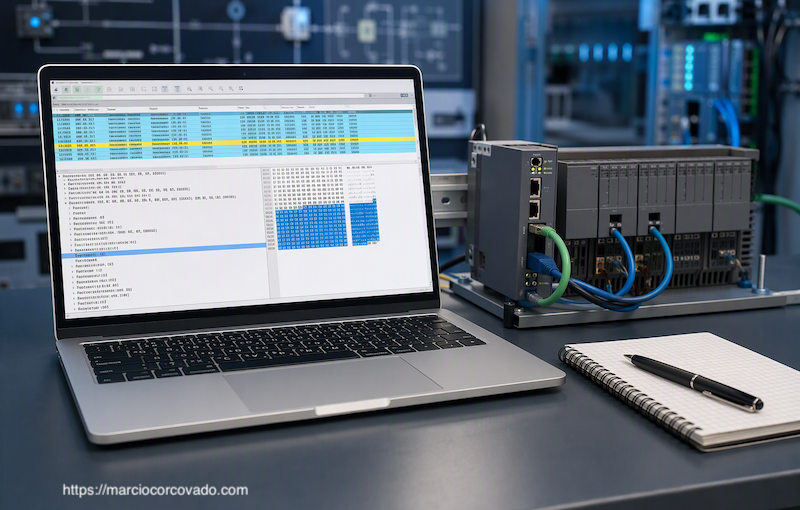
    Sob a ótica da análise forense computacional e perícia digital, a investigação de incidentes em ambientes ICS/SCADA enfrenta obstáculos complexos. A maioria dos dispositivos de campo legados possui limitações severas de processamento e memória, o que impede o armazenamento local de diários de bordo detalhados (audit logs). Diante da ausência de evidências nos endpoints, a reconstituição pericial da cadeia de custódia e do vetor de invasão depende fundamentalmente da captura e análise profunda de tráfego de rede (PCAP), combinada com a identificação de anomalias nos padrões de comunicação do protocolo.

    A superação desses desafios exige o avanço de pesquisas científicas voltadas ao desenvolvimento de modelos de detecção de intrusão não invasivos (Passive Network Monitoring), aplicação de algoritmos de aprendizado de máquina para baselining comportamental e implementação de gateways de tradução segura com suporte a novas especificações, como o Modbus Security. A construção de frameworks periciais adaptados às especificidades do setor industrial é um campo de estudo urgente para garantir a resiliência das infraestruturas estratégicas do país.

    Mentoria de carreira em TI: o perigo das chaves de API no GitHub e como proteger credenciais no seu código desde a faculdade

    Quando estamos desenvolvendo nossos primeiros projetos na faculdade ou criando um portfólio para apresentar em entrevistas de emprego, é muito comum focarmos apenas em “fazer o código funcionar”. No entanto, existe um erro simples e extremamente frequente que pode custar caro e comprometer a reputação de quem está começando na área: colocar senhas, tokens de acesso e chaves de API diretamente no código-fonte (hardcoded) e subir esse projeto para um repositório público no GitHub.

    No momento em que você envia um código contendo uma chave de acesso (como uma credencial da AWS, OpenAI ou um banco de dados) para um repositório aberto, robôs automatizados (scanners) que varrem a internet identificam essa chave em questão de segundos. Se a chave der acesso a um serviço pago de nuvem, esses agentes maliciosos podem usá-la para criar servidores de mineração de criptomoedas, gerando contas astronômicas em seu nome ou vazando os dados da aplicação.

    Para evitar esse tipo de incidente e demonstrar maturidade profissional nos seus projetos acadêmicos, adote a disciplina de Segurança no Desenvolvimento através de duas práticas fundamentais:

    Utilize Variáveis de Ambiente (.env): nunca escreva senhas ou chaves diretamente no arquivo de código (.js, .py, .java). Crie um arquivo separado chamado .env para armazenar suas credenciais e faça com que o seu código leia esses valores a partir do sistema operacional.

    Configure o arquivo .gitignore: antes de fazer o seu primeiro envio (git commit), inclua o arquivo .env dentro do seu .gitignore. Isso garante que as suas senhas permaneçam apenas no seu computador e nunca sejam enviadas para a nuvem pública.

      Aprender a gerenciar credenciais de forma segura desde os primeiros semestres do curso não apenas protege os seus recursos, mas também mostra aos recrutadores e gestores de TI que você já possui a mentalidade e o cuidado de um desenvolvedor maduro. Adote esse hábito hoje mesmo!

      De Data Lakes concentrados à arquitetura Data Mesh: desafios de governança e segurança para o C-Level na gestão de Big Data

      Durante a última década, a estratégia de dados de grande parte das corporações esteve centrada na consolidação de arquiteturas de Data Warehouse e Data Lake em ambientes de nuvem. No entanto, para os líderes do C-Level (CIOs, CDOs e CISOs), o modelo de centralização absoluta do Big Data passou a apresentar gargalos operacionais severos. A dependência de um time central de engenharia de dados para processar, tratar e disponibilizar informações para diferentes unidades de negócio criou um ponto único de falha, desacelerando a tomada de decisões e reduzindo a eficiência organizacional.

      Para superar essas limitações de escala, o paradigma arquitetural do Data Mesh (Malha de Dados) tem ganhado destaque nas discussões de liderança executiva. Fundamentado em quatro pilares — Domínio de Dados descentralizado, Dados como Produto, Plataforma de Dados de Autoatendimento e Governança Computational Federada —, o Data Mesh transfere a responsabilidade da gestão dos dados para as próprias equipes de domínio de negócio que geram a informação.

      Sob a perspectiva da governança corporativa e gestão de riscos, a transição para um modelo descentralizado exige cuidados rigorosos do C-Level. Para evitar o surgimento de silos isolados e o descumprimento de normas regulatórias (como LGPD e GDPR), a liderança deve instituir o conceito de Governança Federada. Isso significa que, embora os negócios tenham autonomia para criar seus “produtos de dados”, os controles de criptografia, controle de acesso baseado em funções (RBAC/ABAC), anonimização e linhagem de dados (Data Lineage) devem ser padronizados e automatizados em nível corporativo por meio de políticas codificadas (Policy-as-Code).

      Ao adotar o Data Mesh com uma governança federada sólida, a alta gestão assegura a democratização do Big Data com agilidade operacional, sem abrir mão do controle de segurança e da conformidade exigir pelo conselho de administração.

      Compreendendo o DLL Side-Loading: a arte da evasão de defesas através da confiança em binários legítimos

      No ecossistema da segurança defensiva (Blue Team) e das simulações de ataque (Red Team), o desvio e a evasão de soluções tradicionais de detecção — como antivírus baseados em assinatura (AV) e plataformas de resposta em endpoint (EDR) — constituem um campo de estudo contínuo. Entre as técnicas de evasão mais refinadas e amplamente exploradas por grupos de ameaças persistentes avançadas (APTs), destaca-se o DLL Side-Loading (ou carregamento lateral de bibliotecas de vinculação dinâmica).

      A vulnerabilidade não reside primariamente em uma falha de estouro de memória, mas sim na lógica de busca e ordenação de dependências executada pelo sistema operacional Windows no carregamento de aplicações. Quando um processo executável (.exe) é iniciado, ele frequentemente requisita bibliotecas externas para a execução de funções específicas. Se o programa não especifica o caminho absoluto (Fully Qualified Domain/Path) da biblioteca necessária, a API do sistema operacional busca a DLL na seguinte ordem prioritária: primeiro no próprio diretório de onde o executável foi lançado e, subsequentemente, nos diretórios do sistema (System32, SysWOW64).

      Agentes de ameaça exploram esse comportamento posicionando um arquivo executável legítimo, homologado e assinado digitalmente por uma entidade confiável na mesma pasta de uma biblioteca maliciosa construída com o mesmo nome e exportações de funções da DLL original. Ao disparar o executável confiável, o sistema operacional carrega a DLL maliciosa local antes de buscar a versão autêntica do sistema. Como a execução ocorre sob o contexto de memória de um processo legítimo e assinado, as ferramentas de monitoramento de comportamento frequentemente falham em sinalizar a anomalia.

      Para mitigar os riscos associados ao DLL Side-Loading, equipes de arquitetura de segurança e auditoria devem implementar controles de endurecimento (hardening) baseados na imposição de mecanismos como o Safe DLL Search Mode, a assinatura digital obrigatória de dependências via Code Integrity, o monitoramento do carregamento de DLLs não assinadas por processos confiáveis através de regras de Event Tracing for Windows (ETW) e a restrição de gravação de arquivos por usuários não privilegiados em diretórios de execução. O entendimento detalhado dessa mecânica é indispensável para formar analistas capazes de antecipar táticas de persistência e evasão no ambiente corporativo.